發表文章

目前顯示的是有「#algorithm」標籤的文章

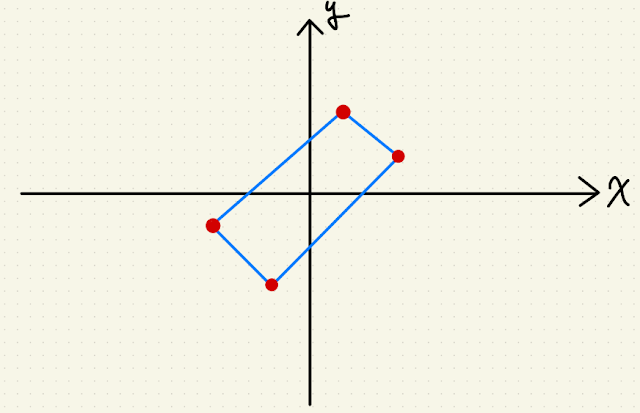
穩健的矩形 OCR 前處理校正技巧 - 特徵點順序校正

圖片
  上個月被派了幾個工項, 其中一個是解我們開單員拍到的車牌照片。 由於我們開單員同仁都是阿伯阿桑, 基本上不太會用 PDA 拍照,所以拍回來的照片都歪歪的。

想知道網戀對象有沒有修圖嗎?試試看這款修圖偵測機器人!

圖片
  前陣子在咱們一群影像愛好者的群組開始流傳一套程式, 一套號稱能檢測愛情動作片封面詐欺的程式!

不均勻光源下的優化 SSIM 演算法

圖片
  這篇是 SSIM 系列第三篇,接續前篇  使用 PyTorch 實做 2D 影像捲積 , 要來談一下 SSIM 如何在不均勻光源下優化 SSIM。

LeetCode 解題紀錄 221. Maximal Square 圖片中最大的正方形

圖片
繼  200. Number of Islands  後,又遇到一個影像處理的問題。 這題要用動態規劃來解,菜雞如我第一時間沒想到動態規劃, 但是後來也自己解出來了,紀錄一下我的解題心路歷程。 題目簡介: 給你一張尺寸為 m x n 像素且只包含(0,1)的圖片稱為 Matrix , 其中 1 代表有像素的區域,找出此張圖片中含有 1 的最大正方形區域面積。 第一階段想法:循序檢測法 把每個點都當作候選正方形的左上角, 先求 Row 再驗證每個 Col 是否符合正方形區域預想? 若有,就回傳正方形區域面積; 若無,就回傳 0。 假設圖片中有 N 個元素,這個想法的時間複雜度為: $$O(N^{2})$$ 但是我們會遇到一個特殊情況,當最大正方形在驗證失敗的候選正方形的的情況, 像是: 就很尷尬,其中 $$S_m$$ 不等於 6 的原因是本圖中最大正方形是交由 min(m, n) 決定, 所以不用檢查到 $$S_m = 6$$ 可以降低計算時間。 結果: Wrong Answer 第二階段:動態規劃法 所以我決定再不增加時間複雜度的情形下,由小到大、每個正方形都檢測。 使用動態規劃,每一步驟又拆成兩小步: 第一步:驗證對角線是否為 '1' ? 第二步:驗證相應 X, Y軸是否為 '1' ? 若有任一步檢測到 '0' ,則回傳步數 S 的平方當作正方形面積。 不過鑑於這個作法時間複雜度遇到 Worst Case (全為 '1' 的圖片時)仍為 $$O(N^{2})$$ 結果: Time Limited Error 第三階段:利用影像(數據)特性降低時間複雜度。 問自己一個問題: 最低滿足圖片中最大正方形的條件是什麼? 答案是任何大於(長/2)*(寬/2)的正方形, 因為本題目中不考慮重疊問題,所以用數學上來說: 一圖片尺寸為 m*n ,若有任意正方形面積大於(m/2 + k)(n/2 + k), 而 k 恆大於零的話,此正方形為圖片中最大的正方形就成立。 而候選次大正方形面積必定為(m/2 - k)(n/2 - k), 所以每個點出發後, 檢測 (m*n/4) + m + n - 1 個像素就知道這個正方形是不是最大的了。 結果: Accept
Structural Similarity(SSIM) 的 PyTorch 實現

圖片
SSIM 是一種指標,用於比較兩張圖的相異程度。 指標主要參考三個面向: 亮度 Luminance $$l(xy) = \frac{2\mu_x\mu_y+C1}{\mu^2_x\mu^2_y+C1}$$ 對比度 Contrast $$c(xy) = \frac{2\sigma_x\sigma_y+C2}{\sigma^2_x\sigma^2_y+C2}$$ 結構相似度 Structure $$s(xy) = \frac{\sigma_{xy}+C3}{\sigma_x\sigma_y+C3}$$

Quick Sort 利用快速排序法解決重複元素排序

圖片
  快速排序算法擁有最佳計算複雜度 O(n log n), 但在特殊情況下會退化成 O(n^2)。 其中一個特殊情況就是大量重複元素的排列問題。 解決問題前, 先介紹快速排序法的實現。 假設你得到一隨機一維陣列要做升冪排序, 最終的結果需要是這樣: 選定隨機陣列最左側為 pivot ,pivot  為 L指標、最右側為 R指標。 首先先判斷終止條件:R 的 index 是否等於 L 的 index? 等於的話就將 pivot 的 值 與 R、L 的值交換,進行下一循環。 R 的 index 不等於 L 的 index的話繼續尋找:  R指標啟動尋找小於等於 pivot 的值,L 尋找大於 pivot 的值,找到就鎖定。     若 R 的 index != L 的 index,則兩者的值交換。 以此類推,當 R 的 index == L 的 index 時,交換 pivot 與 R 的值。 並以交換點為準,分割左邊右邊兩個子循環。 這邊可以順便推導為什麼 quick sort 的計算複雜度為 O(n log n), 因為相較於 bubble sort 中每個 pivot  要比較 n-1 個元素, quick sort 在第二次以後的理想狀況每個 pivot 只需比較 (n/2)^m個元素 (m=排序次數-1)。 所以最佳計算複雜度才會是 O(n log n)  // n個 pivot 乘上該次比較元素量。 但是齁,人算不如天算。 有時候就會遇到很棘手的情況,讓 quick sort  一點都不 quick。 主要分為兩種: 已排序數列。 存在著大量重複元素的數列。     1. 已排序數列。 已排序數列的問題在於分割的左右子陣列不平衡, 導致需要搜尋的元素趨近於 n。 如此一來計算複雜度便會退化成 O(n^2) 解法:把數列打亂即可解決這個問題。      2.存在著大量重複元素的數列。 這個就比較麻煩了,因為打亂也解決不了(#。 這個問題在於要搜尋相等於 pivot 的重複數, 兩數之間總共有三種關係嘛:大於、等於、小於。 之前的方法一直把等於的方法掛在 L指標上面做, 解決問題的核心精神是特別考慮等於的情況處理。 重複數處理...

The Devil is in the Pose: Ambiguity-free 3D Rotation-invariant Learning via Pose-aware Convolution 論文導讀

圖片
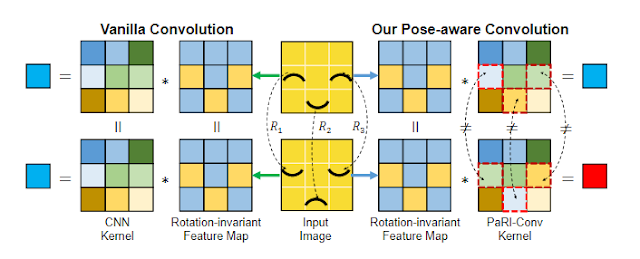
  本文建議有點雲特徵的先驗知識者閱讀, 我會盡量講得平易近人, 但仍建議請先參考 此篇 ,先了解基本點雲處理如何處理特徵。 這篇論文的重點在於改變了底層特徵方法。 論文中由這張圖來解釋: 因為現行解決 Rotation Invariant 的方法都是乘上一個矩陣去收集數據, 並沒有考慮點與點之間的結構關係(i.e.上圖笑臉)。 但是我覺得這個例子呈述得很容易誤導, 聽起來很像在解決高低解析度、上下採樣的問題, 實際上在點雲裡面應該是解決類似 KNN 特徵的問題才對。 像是那三個有黑色像素的點,間隔距離、彼此夾角之類的結構關係所產生的資訊。 作者認為現在的 CNN 都沒有抓到結構關係 (Pose) 的精華 (e.g. 點雲中點與點的區域關係 AKA 底層特徵), 所以要提出解決方法稱為 PaRI 的新架構來解決問題 (我猜是 Pose: Ambiguity-free 3D Rotation-invariant 的縮寫)。 舊有的底層特徵方法: 好,那要改進一定得知道改哪裡嘛? 之前別人是怎麼做這種結構特徵的? 答案是:Point Pair Feature(PPF) Point Pair Peature Pr 是參考點,想像成 KNN 的目標點; Pj 是 Pr 附近的鄰居點,有 K 個; ∂n_r 是相較於 r 的三維座標軸,用  gram-schmidt orthogonalization 算出來的, 忘記的同學可以去複習一下 GSO 。 所以經過 PPF 計算,我們會得到一組四個特徵如下圖: 這樣會出個小問題,各位想想好的底層特徵應該要具備什麼特性? 應該要具備獨特性嘛! 因為這樣訓練起來才不會與其他特徵混淆。 仔細觀察 αn 的方程式我們會發現,沒有一條能分辨在這個半徑為 d 的圓圈上, 有若干個法向量相同的  Pj 的辦法。  (∂1_r, ∂1_j 分別代表各自的法向量,ModelNet40資料集會給定。) 改善方法: 在改善之前,我們先想想舊有方法遇到什麼問題? 問題是缺少 Pr 與 Pj 間的獨特特徵,對吧? 所以我們希望新的方法最好讓每個 Pj 對 Pr 有獨特性。 Local Reference Frame(LRF) +   Augmented Point Pa...

費波納契數列的最佳計算複雜度 O(logn) 實現及推導(fibonacci sequence in cpp)

圖片
因為最近在解 Leetcode 的  91.   Decode Ways , 要用到 Fibonacci  sequence  來解,就我所知上次解  70 .  Climbing Stairs  的時候, 用 recursive 求解   Fibonacci   sequence 的時候會 TLE。 (所以我就偷懶跑去用 Python3 解大數) 這次再遇到應該是要進步了xDDD 正文開始: Fibonacci  sequence 會長這個樣子: 根據基本定義,第 N 個  Fibonacci value 等於前兩個  Fibonacci value 相加, 我們便可以得到公式: 得到公式以後把它擴展成 轉移矩陣 M 的形式, 因為我們把前兩項當作初始值,所以 轉移矩陣 M 的指數會減二: 所以我們現在只要計算 M 的 (n-2) 次方就能得到第 N 個  Fibonacci value。 (左上角的 M00 會等於 第N個  Fibonacci value ) 此時的計算複雜度為: O(n) 以第 45 個 value 值來比較,此方法已經比遞迴快很多了xD 但是我還要教你一個威力加強版外掛:平方求冪 (左岸又稱快速冪 or  double-and-add ) 我們在這裡要用平方求冪去優化轉移矩陣 M。 平方求冪的想法是把任何高階指數都化為與指數二有關的指數和, 屁話一堆直接看數學比較快: 如果你說 n 是 odd 怎麼辦? 啊不簡單?直接減一再乘回去R~: 這樣的好處是能大大的減少計算量,數學意義上來說是二分搜尋法, 以找 n = 16 舉例, 沒有平方求冪的版本會很老實地計算十五次乘法, 而有平方求冪外掛的版本會跳著算: 像是圖中有幾個節點,就計算幾次, 每次都是跟自己相乘,所以實際上只要算黃色螢光筆那條路徑, 不必考慮其他條黑色路徑。 由此可以 16 = 2^4,所以有 4 個節點,只需計算 4次。 此時又可推導出 計算複雜度為: O(logn) (log 以 2 為底。) 用 C++ 實現的程式碼我放在 這裡 有興趣的可以直接拿來用,不用再造車輪了xD 感謝各位